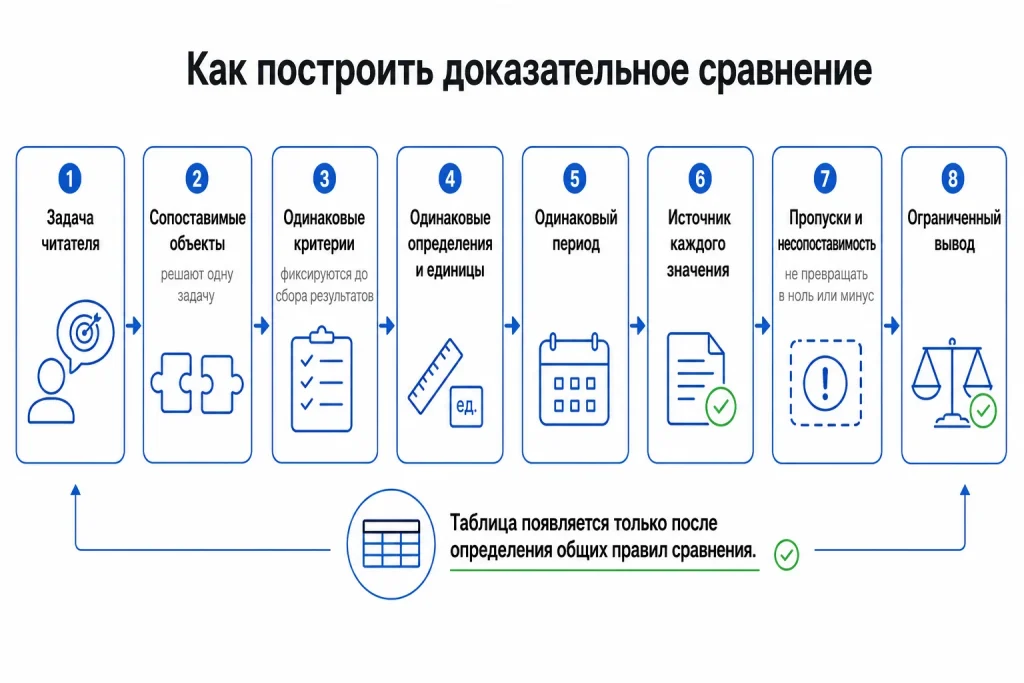
Сравнительная статья начинает вводить в заблуждение не тогда, когда в ней появляется явная ошибка. Достаточно поставить рядом данные, которые получены в разных условиях, выбрать удобные критерии только для одного варианта или заменить неизвестное значение минусом.
Хорошее сравнение строится в обратном порядке. Сначала редактор определяет, какое решение должен принять читатель и какие объекты вообще можно сопоставлять. Затем фиксирует одинаковые критерии, определения, единицы, периоды и источники. Только после этого появляется таблица и вывод.
Начните с решения, ради которого проводится сравнение
Фраза «сравним три сервиса» ещё не задаёт задачу.
Одни и те же продукты можно сравнивать по:
- цене;
- функциям;
- скорости внедрения;
- требованиям к инфраструктуре;
- поддержке;
- ограничениям;
- стоимости владения;
- условиям для конкретного сценария.
Если заранее не определить пользовательскую задачу, набор критериев легко превращается в случайный каталог характеристик.
Например, для компании с собственной IT-командой наличие готового no-code редактора может быть второстепенным. Для небольшой команды без разработчиков тот же критерий меняет решение.
Поэтому перед сбором данных полезно записать одну фразу:
Сравнение должно помочь выбрать вариант для ______ при условиях ______.
Эта формулировка затем определяет и критерии, и границы финального вывода.
Сравнивать нужно объекты, которые решают одну задачу
Два продукта могут находиться в одной категории и при этом плохо заменять друг друга.
Например, один сервис рассчитан на самостоятельную работу малого бизнеса, другой — на внедрение внутри крупной организации с отдельной командой интеграции. Сравнение только по цене подписки будет формально возможным, но практически мало что скажет.
В актуальных рекомендациях CAP для сравнительных рекламных claims есть близкое требование: сравниваемые продукты должны удовлетворять одной потребности или быть предназначены для одной цели. Для редакционной статьи это полезно и вне рекламного контекста.
Перед сравнением стоит проверить:
- решают ли варианты одну пользовательскую задачу;
- предназначены ли для сопоставимой аудитории;
- одинаков ли масштаб использования;
- не сравнивается ли базовый продукт с комплексной услугой;
- не относится ли один вариант к другому классу решения.
Если объекты различаются фундаментально, это не запрещает ставить их рядом. Но основание сравнения нужно назвать явно.
Сначала критерии, потом данные
Одна из самых частых ошибок возникает, когда редактор изучает продукты по очереди.
У первого он замечает цену и поддержку.
У второго — интеграции и безопасность.
У третьего — скорость запуска и красивый интерфейс.
В результате таблица содержит разные достоинства разных объектов и выглядит подробной, хотя сравнения как такового нет.
Рабочий порядок другой:
задача читателя
↓
объекты
↓
единый набор критериев
↓
данные по каждому критерию
↓
пропуски
↓
вывод
Если критерий важен, его нужно попытаться проверить у всех сравниваемых вариантов.
Критерий должен менять решение
В таблицы часто попадают характеристики только потому, что их легко найти.
Например:
- год основания компании;
- число страниц на сайте;
- наличие мобильного приложения;
- количество шаблонов.
Все эти данные могут быть достоверными и при этом бесполезными для конкретного выбора.
Хороший вопрос к каждому критерию:
если значения у вариантов различаются, может ли это разумно изменить решение читателя?
Если нет, поле только увеличивает таблицу.
CAP для объективных сравнений использует понятия material, relevant и representative feature. В редакционном контексте это можно перевести в практическое требование: сравнивать существенные и релевантные свойства, а не выбирать удобную мелочь, которая создаёт нужное впечатление.
Нельзя подбирать критерии после того, как известен победитель
Представим, что автор заранее предпочитает вариант A.
Он выбирает:
- три функции, которые есть у A;
- один тариф, где A дешевле;
- награду, которую получил A;
- показатель, который конкурент вообще не публикует.
Таблица может состоять из достоверных строк, но её конструкция уже предопределяет вывод.
Чтобы уменьшить такой риск, критерии полезно фиксировать до заполнения значений.
Для сложного материала можно сохранить короткую запись:
Задача выбора:
Критерии:
Почему каждый критерий важен:
Что не включаем:
Почему не включаем:
Эта дисциплина особенно полезна, если статья сравнивает собственный продукт компании с конкурентами.
Одинаковое название показателя ещё не гарантирует сопоставимость
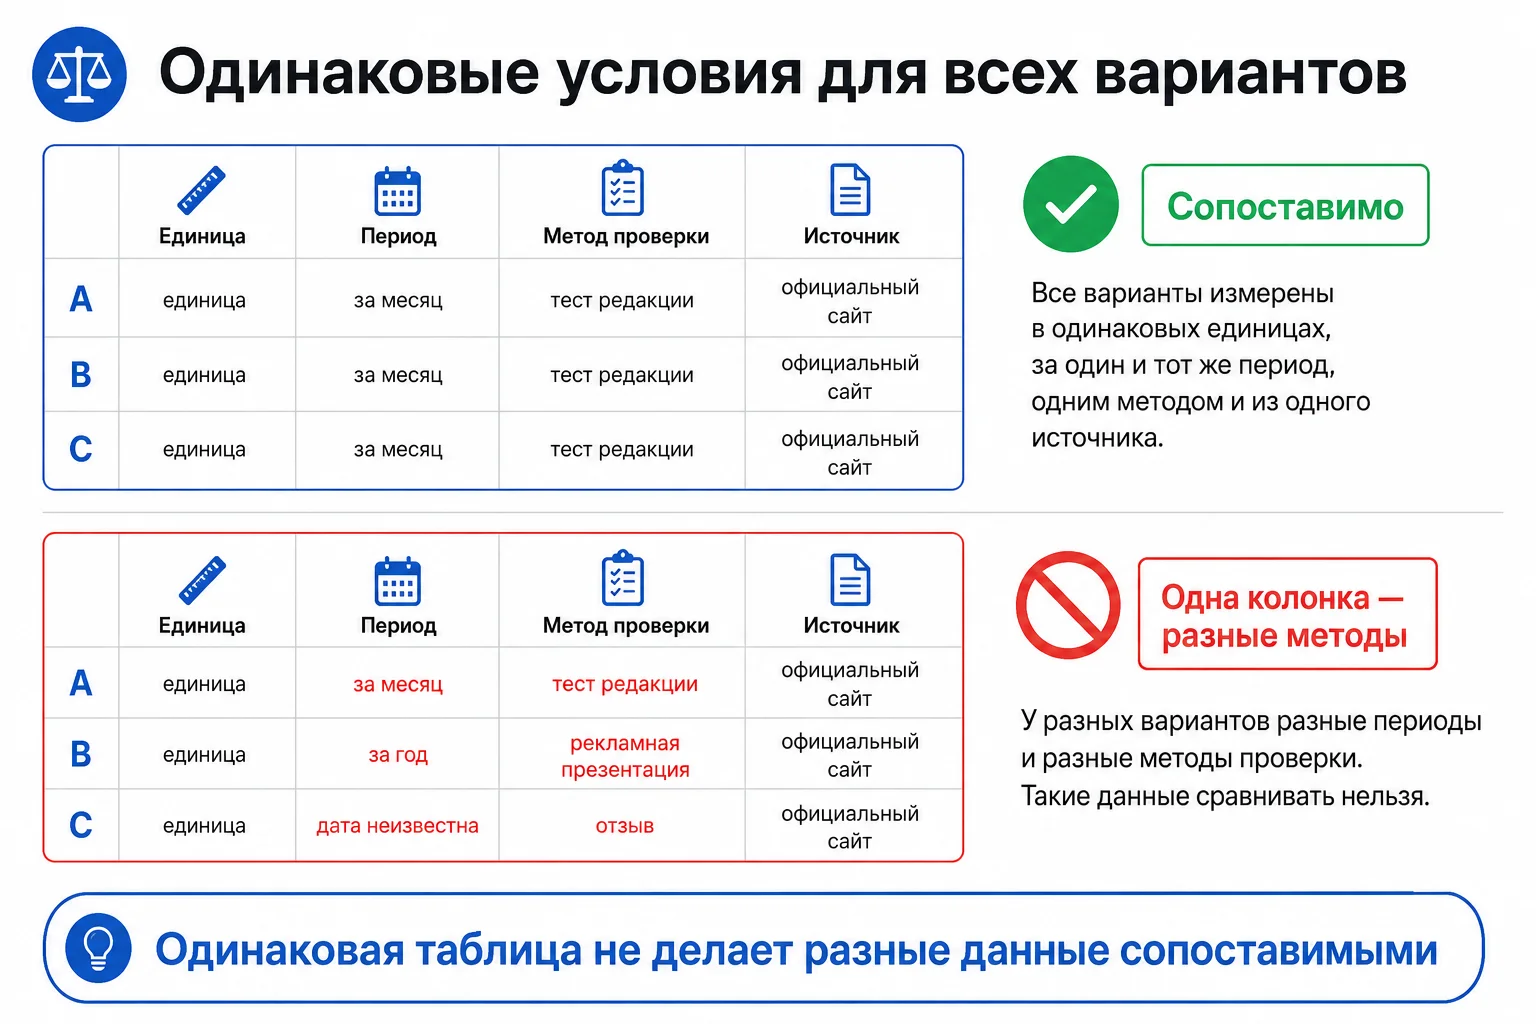
Два источника публикуют «стоимость клиента».
У одного в расчёт входят только рекламные расходы.
У другого — реклама, зарплата отдела продаж и стоимость сервисов.
Числа называются одинаково, но означают разные величины.
ONS показывает эту проблему на статистических данных: оценки одной и той же переменной могут различаться из-за разных выборок, периодов сбора и определений. В документации ONS comparability прямо описывается как степень, в которой данные можно сравнивать во времени и между областями.
Поэтому перед сравнением нужно проверить не только название, но и определение каждого показателя.
Единицы должны быть одинаковыми
Очевидная ошибка:
Вариант A — 15 000 рублей, вариант B — 250 долларов.
Но есть и менее заметные версии:
- цена за пользователя против цены за команду;
- месячный тариф против годовой суммы;
- стоимость без налога против полной стоимости;
- гигабайты против терабайтов;
- время на одну операцию против времени на сто операций;
- абсолютное число против доли.
Перед публикацией значения нужно привести к одной базе или явно оставить несопоставимыми.
Иногда правильная ячейка в таблице — не число, а пояснение:
Нельзя сравнить напрямую: разные модели тарификации.
Цена требует одинаковой комплектации
Фраза:
Сервис A дешевле сервиса B.
имеет смысл только после ответа на несколько вопросов:
- какие тарифы сравниваются;
- одинаково ли число пользователей;
- включены ли необходимые функции;
- есть ли обязательные дополнительные платежи;
- одинаков ли срок оплаты;
- действуют ли временные скидки.
CAP в свежем руководстве по verifiability приводит показательный принцип: для проверяемого сравнения нужно раскрывать базу сравнения, а при необходимости — конкретные продукты, дату, методику и исходные данные.
Для редактора практическая формула та же:
сначала собрать одинаковую конфигурацию, потом сравнивать цену.
Период должен совпадать с задачей сравнения
Один показатель взят за 2025 год, другой — за первые шесть месяцев 2026-го.
Формально оба числа актуальны. Но прямое сравнение может быть бессмысленным.
Нужно проверить:
- одинаковы ли даты;
- полные ли периоды;
- не сезонный ли показатель;
- не изменилась ли методика;
- не вышла ли более свежая версия данных по одному объекту.
ONS при работе с сопоставимостью временных рядов отдельно учитывает методологические изменения и по возможности пересчитывает предыдущие данные так, чтобы они оставались сравнимыми.
В B2B-статье обычно нет возможности пересчитать внешний источник. Тогда расхождение периодов нужно просто показать.
Дата сравнения должна быть видна читателю
Особенно быстро устаревают:
- тарифы;
- функции SaaS-продуктов;
- лимиты;
- условия поддержки;
- интеграции;
- рыночные позиции.
Если таблица говорит «есть / нет», через месяц одна ячейка может уже стать неверной.
Поэтому для изменяемых характеристик полезно зафиксировать:
Данные проверены на 20 августа 2026 года.
или указать дату возле самой таблицы.
Это не решает проблему обновления, но показывает временную границу утверждения.
Каждое значение должно иметь собственное происхождение
Сравнительная таблица создаёт сильный визуальный эффект: все строки выглядят одинаково проверенными.
На самом деле происхождение данных может различаться:
- официальная документация;
- тарифная страница;
- ответ поддержки;
- независимый тест;
- опрос пользователей;
- собственное измерение редакции.
Поэтому редактору полезно хранить матрицу:
объект
+
критерий
+
значение
+
источник
+
дата
+
комментарий к сопоставимости
Выбор подходящего типа источника для claim разобран отдельно в статье о первичных и вторичных источниках в экспертном тексте.
Одна ссылка под таблицей редко подтверждает все ячейки
Представим таблицу из десяти критериев и трёх продуктов.
Под ней одна строка:
Источники: сайты производителей.
Читатель не понимает:
- какая страница подтверждает конкретную функцию;
- когда проверялась цена;
- откуда взят результат теста;
- что было измерено самой редакцией.
Для рабочих материалов лучше хранить источник на уровне ячейки или строки. В опубликованной статье способ отображения зависит от объёма, но связь должна оставаться восстанавливаемой.
Актуальное руководство CAP по проверяемым сравнениям отдельно подчёркивает, что одной общей ссылки недостаточно, если она не позволяет понять продукты, дату, методику и основу сравнения.
Как показать связь между конкретным claim и evidence, подробно разобрано в статье о цитате, пересказе и атрибуции источника.
«Нет данных» и «нет функции» — не одно и то же
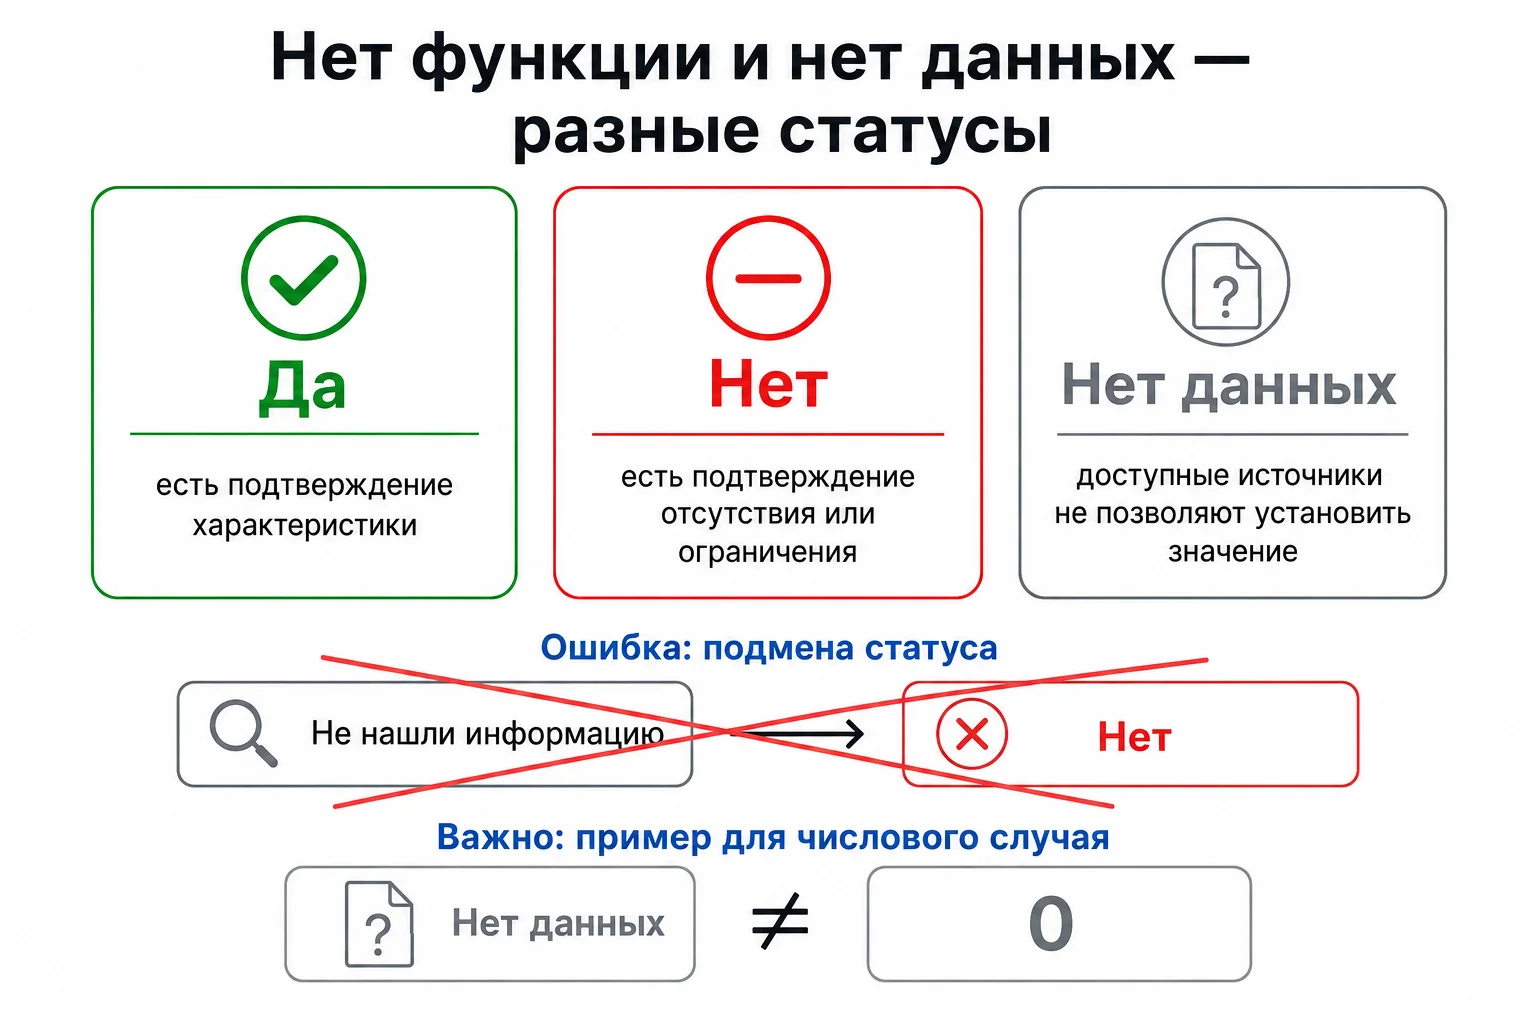
Одна из самых опасных ячеек сравнительной таблицы — красный крест.
Редактор не нашёл функцию в документации и ставит:
Нет.
Но фактически он знает только:
Не нашли подтверждения в доступной документации.
Это разные утверждения.
Вместо бинарного «да / нет» иногда нужны три состояния:
| Статус | Что он означает |
|---|---|
| Да | Есть подтверждение функции или характеристики |
| Нет | Есть надёжное подтверждение отсутствия или ограничения |
| Нет данных | Доступные материалы не позволяют установить значение |
Пропуск не нужно превращать в минус только ради симметричной таблицы.
Неизвестное значение нельзя заменять нулём
То же относится к числам.
Если компания не раскрывает количество интеграций, значение:
0
будет означать, что интеграций нет.
Корректнее:
Нет публичных данных.
Ноль — это измеренное значение.
Пропуск — отсутствие доступного значения.
При последующем расчёте рейтинга смешение этих состояний особенно сильно искажает результат.
Не заполняйте пропуск данными из другого периода без пометки
Для двух вариантов есть показатели за июль 2026 года, а для третьего удалось найти только число за декабрь 2025-го.
Редактор может использовать старое значение как справочное, если оно всё ещё полезно.
Но в таблице должна быть видна дата:
12,4% — данные за декабрь 2025 года.
Иначе визуально три значения выглядят одинаково актуальными.
Сопоставимость нельзя создавать форматированием.
Субъективный критерий нужно обозначить как субъективный
Например:
- удобство интерфейса;
- простота настройки;
- качество дизайна;
- понятность документации.
Такие характеристики можно сравнивать, но сначала нужно определить метод.
Варианты:
- оценка редакции по заранее заданной шкале;
- пользовательский тест;
- опрос определённой аудитории;
- экспертная оценка с раскрытым критерием.
Нельзя выдавать личное впечатление автора за объективную характеристику:
У сервиса A интерфейс удобнее.
Если это редакционная оценка, лучше так и написать:
В тестовом сценарии редакции сервис A потребовал меньше действий для выполнения выбранной задачи.
Теперь появился наблюдаемый критерий.
Опрос не заменяет техническое измерение
Пользовательский опрос может хорошо отвечать на вопрос:
Какой вариант участники считают более удобным?
Но он не обязательно подтверждает:
Какой вариант объективно быстрее обрабатывает запрос?
CAP в рекомендациях по сравнительным claims отдельно предупреждает, что субъективные ответы потребителей недостаточны для утверждений, которые требуют объективной доказательной базы.
В экспертной статье нужно сохранять то же разделение:
восприятие
≠
измеренная характеристика
Если есть тест, условия теста должны быть одинаковыми
Фраза:
Вариант A оказался в два раза быстрее B.
имеет смысл, если известно:
- какая операция измерялась;
- на каком оборудовании;
- с какими настройками;
- на каком объёме данных;
- сколько было повторов;
- как рассчитывался итоговый показатель;
- какие версии продуктов участвовали.
Если A тестировали на новом сервере, а B — на старом ноутбуке, точность секундомера не спасёт сравнение.
Актуальное руководство CAP по verifiability также требует для тестовых сравнений достаточных сведений о методике и результатах, чтобы основание claim можно было проверить.
Не меняйте методику для «неудобного» объекта
У двух сервисов скорость проверили самостоятельно.
У третьего тест не получился, поэтому редактор берёт цифру из рекламной презентации производителя.
В таблице все три значения оказываются в одной колонке.
Это слабая конструкция.
Если методы происхождения значений различаются, нужно:
- либо привести данные к одному способу измерения;
- либо разделить источники;
- либо пометить значение как несопоставимое;
- либо убрать критерий из итогового ранжирования.
Одинаковая колонка предполагает одинаковый смысл данных.
Рейтинг требует весов, а веса требуют объяснения
После таблицы часто хочется получить итог:
Вариант A — 8,7 балла, B — 7,9, C — 7,2.
Но рейтинг создаёт новый набор вопросов:
- как переводились исходные значения в баллы;
- все ли критерии имеют одинаковый вес;
- кто определил веса;
- что произошло с пропусками;
- компенсирует ли высокая оценка одного параметра критический недостаток другого.
Если методики нет, десятичный рейтинг только создаёт видимость точности.
Для экспертной статьи часто полезнее написать:
Вариант A подходит, если приоритет — X. Вариант B рациональнее при условии Y. Для сценария Z данных недостаточно, чтобы уверенно выбрать между ними.
Так вывод остаётся связан с задачей читателя.
Критические требования лучше отделить от желательных
Представим, что компания выбирает решение, которому обязательно нужна интеграция с внутренней системой.
У продукта A этой интеграции нет.
При этом A выигрывает по пяти второстепенным критериям.
Средний балл может поставить его на первое место, хотя для заданного сценария продукт непригоден.
Поэтому перед сравнением полезно разделить критерии:
- обязательные — без них вариант исключается;
- сравнительные — помогают выбрать среди оставшихся;
- дополнительные — влияют на удобство, но не определяют решение.
Это делает итог менее эффектным, но намного полезнее.
«Лучший» существует только относительно критерия
Фраза:
Сервис A — лучший из трёх.
слишком широка, если сравнение охватывало только цену и две функции.
Точнее:
Из трёх рассмотренных вариантов A имеет минимальную стоимость при заданной конфигурации.
или:
Для команды, которой нужны функции X и Y без отдельной интеграции, A лучше соответствует заданным критериям.
CAP рассматривает объективные claims вроде «best» или «leading» как сравнительные и требует доказательств, соответствующих тому смыслу, который читатель разумно из них извлечёт.
В редакционной статье этот принцип помогает не превращать узкий результат в глобальный рейтинг.
Сравнение может закончиться без единственного победителя
Это нормальный результат.
Например:
| Сценарий | Рациональный выбор |
|---|---|
| Минимальная цена при базовых функциях | Вариант A |
| Сложная интеграция | Вариант B |
| Нет собственной технической команды | Вариант C |
Такой вывод полезнее искусственного общего места №1.
Экспертное сравнение отвечает не «кто победил вообще», а «какой вариант соответствует заданным условиям».
Пропуски должны ограничивать силу вывода
Если у одного продукта неизвестна стоимость внедрения, нельзя уверенно заявлять:
Вариант A дешевле всех по полной стоимости владения.
Можно написать:
По опубликованным тарифам A дешевле двух других вариантов, но полную стоимость владения сравнить нельзя: по одному из продуктов нет данных о внедрении.
Неизвестность здесь не дефект текста.
Это часть результата исследования.
Не прячьте важное исключение в сноске
Таблица:
A — 10 000 ₽
B — 14 000 ₽
C — 16 000 ₽*
Сноска:
*Цена C указана за вдвое больший лимит пользователей.
Формально уточнение есть. Но визуально читатель уже получил неправильное ранжирование.
Если условие меняет смысл сравнения, его нужно включать в сам критерий или рядом со значением.
Сноска подходит для детали. Она плохо подходит для факта, без которого основной вывод становится неверным.
Сравнительная таблица — это сериализация данных, а не замена анализа
Таблица хороша, когда у объектов есть повторяющаяся структура:
один критерий
→ значения по всем объектам

следующий критерий
→ значения по всем объектам
Но таблица не объясняет автоматически:
- почему выбран критерий;
- откуда взялись данные;
- какие значения несопоставимы;
- какие ограничения влияют на вывод.
Поэтому перед таблицей нужен контекст, а после неё — интерпретация.
Само наличие строк и столбцов ещё не делает материал доказательным.
Когда таблица не нужна
Если сравниваются два подхода, которые отличаются не набором характеристик, а логикой применения, таблица может только упростить смысл.
Например, один подход подходит для быстрых изменений с низкой стоимостью ошибки, другой — для решений, где нужен долгий цикл согласования.
Здесь полезнее структура:
- в каких условиях работает первый;
- в каких — второй;
- где у каждого ограничения;
- какие данные нужны для выбора.
Формат нужно выбирать после понимания структуры сравнения, а не потому, что сравнительная статья «должна содержать таблицу».
Как работать с характеристикой, которую нельзя измерить одинаково
Например, у трёх поставщиков разная модель поддержки:
- у одного — фиксированное время ответа;
- у второго — уровни приоритета;
- у третьего — персональный менеджер без опубликованного SLA.
Свести всё к колонке «Скорость поддержки» и расставить 5, 4 и 3 балла будет слишком грубо.
Лучше сохранить реальные условия:
| Вариант | Как устроена поддержка |
|---|---|
| A | Опубликован SLA по времени первого ответа |
| B | Срок зависит от уровня приоритета обращения |
| C | Есть персональный менеджер, публичного SLA нет |
Иногда честное несведение данных к одной шкале делает сравнение полезнее.
Сравнение должно позволять проверить себя
Читатель не обязан повторять весь редакционный анализ.
Но для сильного вывода должно быть понятно:
- что сравнивали;
- по каким критериям;
- на какую дату;
- откуда взяты значения;
- как проводился тест, если он был;
- какие данные отсутствуют;
- почему сделан именно такой вывод.
Свежие рекомендации CAP по verifiability строятся вокруг похожей идеи: аудитория должна иметь возможность понять основание сравнения и проверить claim, а при сложной методике должны быть доступны сведения о продуктах, методе и результатах.
Для экспертной статьи это хороший тест качества даже там, где рекламные правила напрямую не применяются.
Редакторская карточка сравнения
Задача читателя:

Объекты сравнения:

Почему объекты сопоставимы:

Обязательные критерии:

Сравнительные критерии:

Определение каждого критерия:

Единица:

Период / дата:

Источник по каждому значению:

Метод проверки:

Пропуски:

Несопоставимые значения:

Ограничения:

Правило итогового вывода:

Финальная формулировка:
Карточка помогает не менять правила по ходу сбора данных.
Короткий алгоритм доказательного сравнения
- Сформулировать решение, которое должен принять читатель.
- Выбрать объекты, которые действительно решают сопоставимую задачу.
- Зафиксировать критерии до заполнения таблицы.
- Отделить обязательные критерии от дополнительных.
- Определить каждую метрику.
- Привести единицы к одной базе.
- Проверить периоды и версии.
- Сохранить источник каждого значения.
- Отдельно отметить неизвестные данные.
- Не смешивать субъективные оценки с измеренными характеристиками.
- Проверить, одинаково ли проводились тесты.
- Сделать вывод только в границах реально проверенных критериев.
Диагностическая таблица
| Проблема | Что проверить |
|---|---|
| Один вариант явно выигрывает почти по всем строкам | Не подбирались ли критерии после знакомства с результатами |
| В одной колонке разные типы значений | Одинаковы ли определения и единицы |
| Цены сильно различаются | Одинакова ли комплектация и период оплаты |
| У одного варианта стоит «нет» | Есть ли доказательство отсутствия или данные просто не найдены |
| В рейтинге много десятичных баллов | Есть ли формула, веса и правило обработки пропусков |
| Опрос подтверждает техническое превосходство | Не перепутано ли восприятие с объективным измерением |
| Сравниваются результаты тестов | Одинаковы ли версии, настройки, оборудование и метод |
| Одна ссылка стоит под всей таблицей | Можно ли восстановить источник каждого сильного значения |
| Вывод звучит «лучший» | По какому критерию и для какого сценария |
| Нет данных по одному объекту | Не стал ли пропуск нулём или скрытым минусом |
Где заканчивается T7
Эта статья не решает вместо редактора предыдущие задачи.
Если неизвестно, какой источник надёжнее, сначала нужно проверить происхождение информации.
Если непонятно, действительно ли источник поддерживает конкретную строку, нужно разобрать claim и evidence.
Если в таблице есть процент, который невозможно воспроизвести из исходных данных, нужен отдельный фактчек расчёта.
T7 начинается позже: когда объекты и evidence уже найдены и требуется построить честную сравнительную рамку, в которой одинаковые критерии применяются ко всем вариантам.
Итог: хорошее сравнение не обязано выбирать одного победителя
Рабочая модель выглядит так:
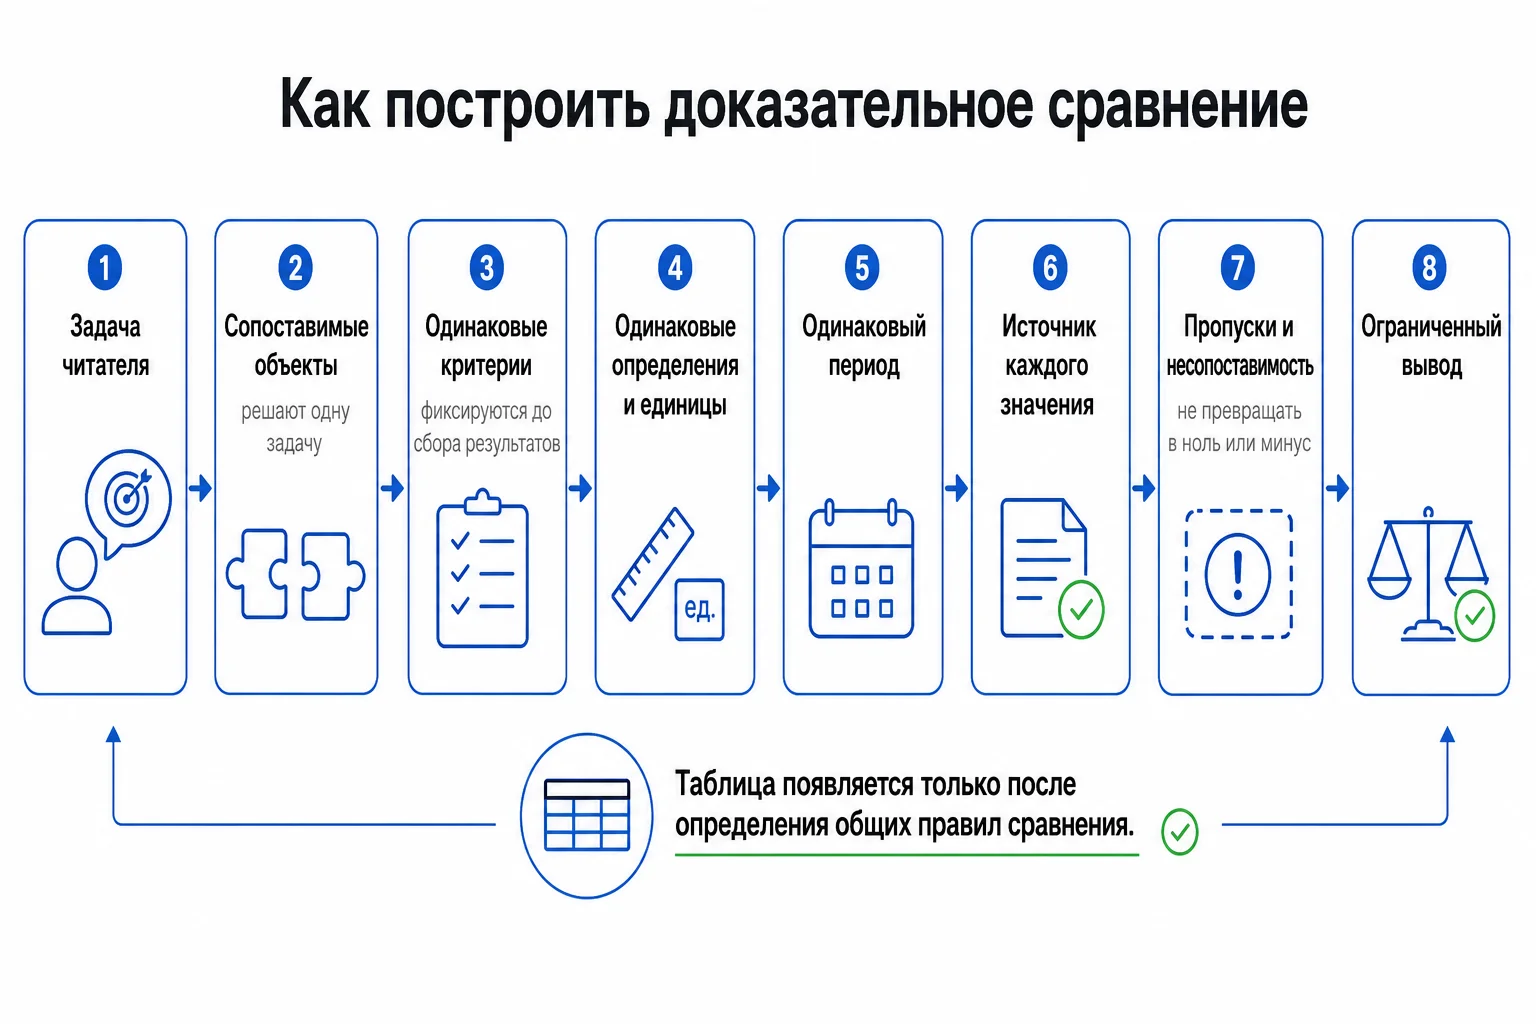
задача читателя
↓
сопоставимые объекты
↓
одинаковые критерии
↓
одинаковые определения и единицы
↓
одинаковый период
↓
источник каждого значения
↓
пропуски и несопоставимость
↓
ограниченный вывод
Сравнение становится полезным не тогда, когда таблица заполнена полностью.
Оно становится полезным, когда читатель понимает, что именно сравнивали, по каким правилам и где эти правила перестают работать.
Иногда результатом будет один лучший вариант для заданного сценария. Иногда — разные варианты для разных задач. А иногда данных окажется недостаточно для уверенного победителя.
Последний вариант тоже нормален. Честное «нельзя установить по доступным данным» сильнее красивого рейтинга, построенного на несопоставимых значениях.
Источники
Источники проверены 20 августа 2026 года.
- ASA / CAP — Comparisons: Verifiability
- ASA / CAP — Comparisons: Identifiable competitors
- ASA / CAP — Substantiation
- ASA / CAP — Comparisons based on awards or surveys
- Office for National Statistics — Comparison of labour market data sources
- Office for National Statistics — Annual Business Survey technical report
- Office for National Statistics — Data visualisation principles